System dedykowany
Cyber Katalog
Serwis o polskim rynku cyberbezpieczeństwa: wyszukiwarka firm, profile z danymi rejestrowymi i strukturą właścicielską, aktualności, oferty pracy, słownik i narzędzia. Dane pochodzą z kilku źródeł i odświeżają się zaplanowanymi zadaniami, a ich poprawności pilnują testy w CI.
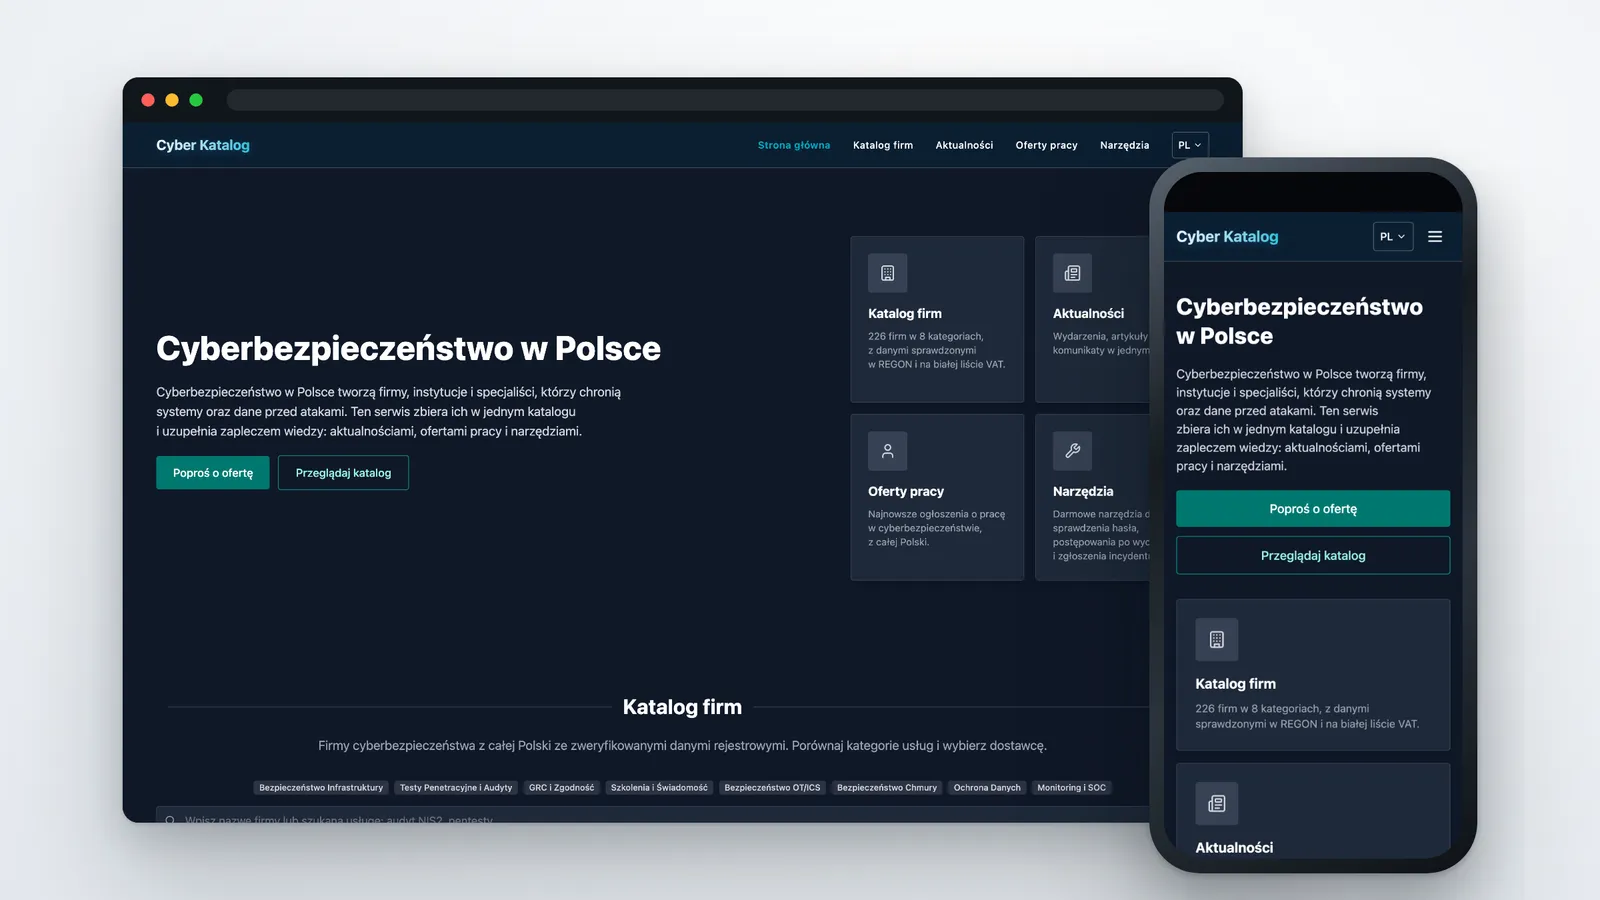
Cyber Katalog, serwis o polskim rynku cyberbezpieczeństwa, ma dziś ponad dwieście zweryfikowanych firm w ośmiu kategoriach, słownik pojęć i kilkadziesiąt walidatorów pilnujących każdego builda. Pod cyberkatalog.pl działa wyszukiwarka firm razem z zapleczem wiedzy: aktualnościami, ofertami pracy, słownikiem i narzędziami. API odpowiada pod api.cyberkatalog.pl, a osobne proxy pod cert.cyberkatalog.pl doprowadza Listę Ostrzeżeń CSIRT NASK.
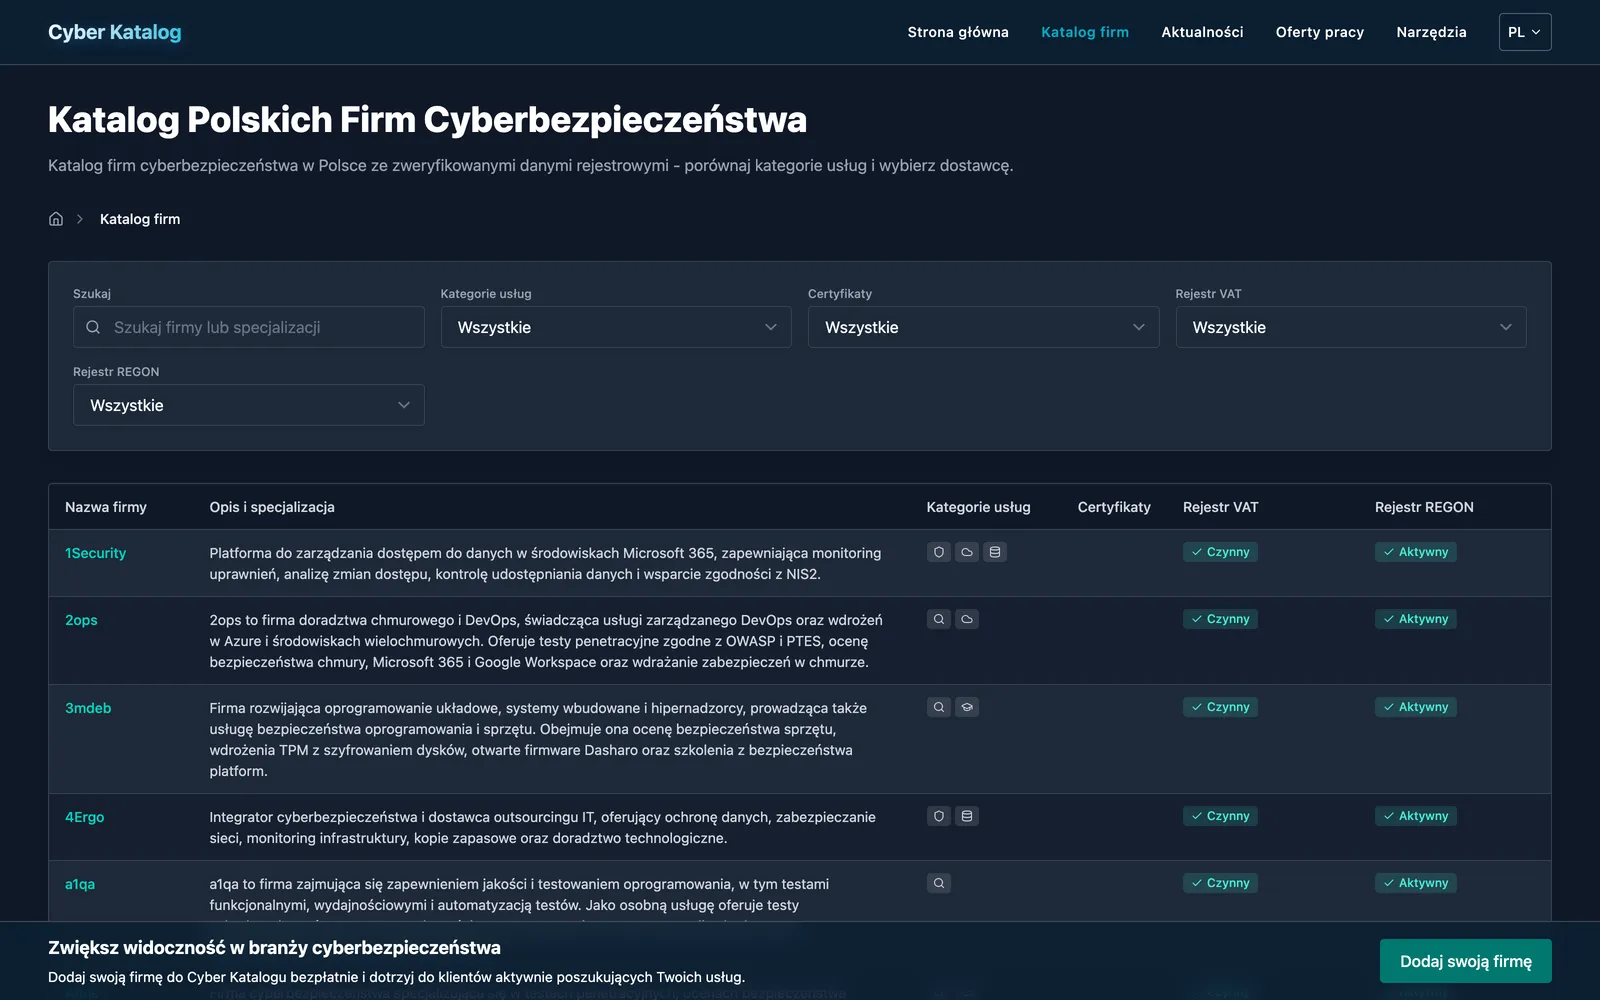
Skąd biorą się dane
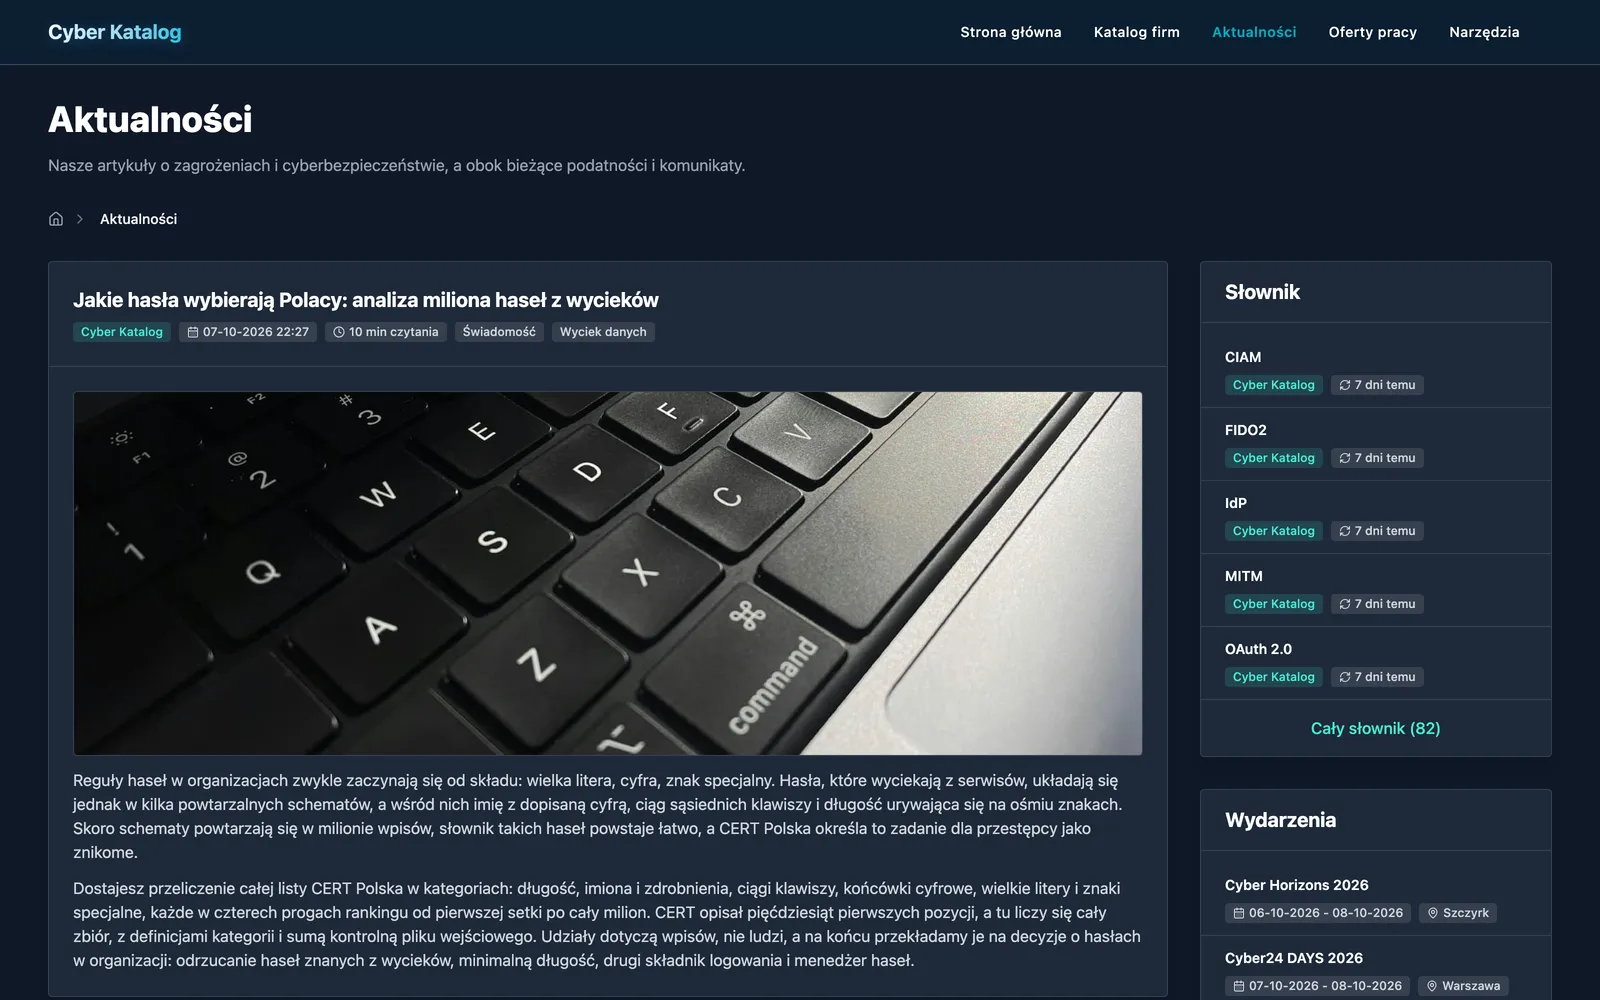
Redakcyjna część katalogu żyje z kanałów RSS, instytucjonalnych i branżowych, z których powstają aktualności, zbierane cyklicznie i wiązane z identyfikatorami CVE, bez ręcznego kroku po drodze.
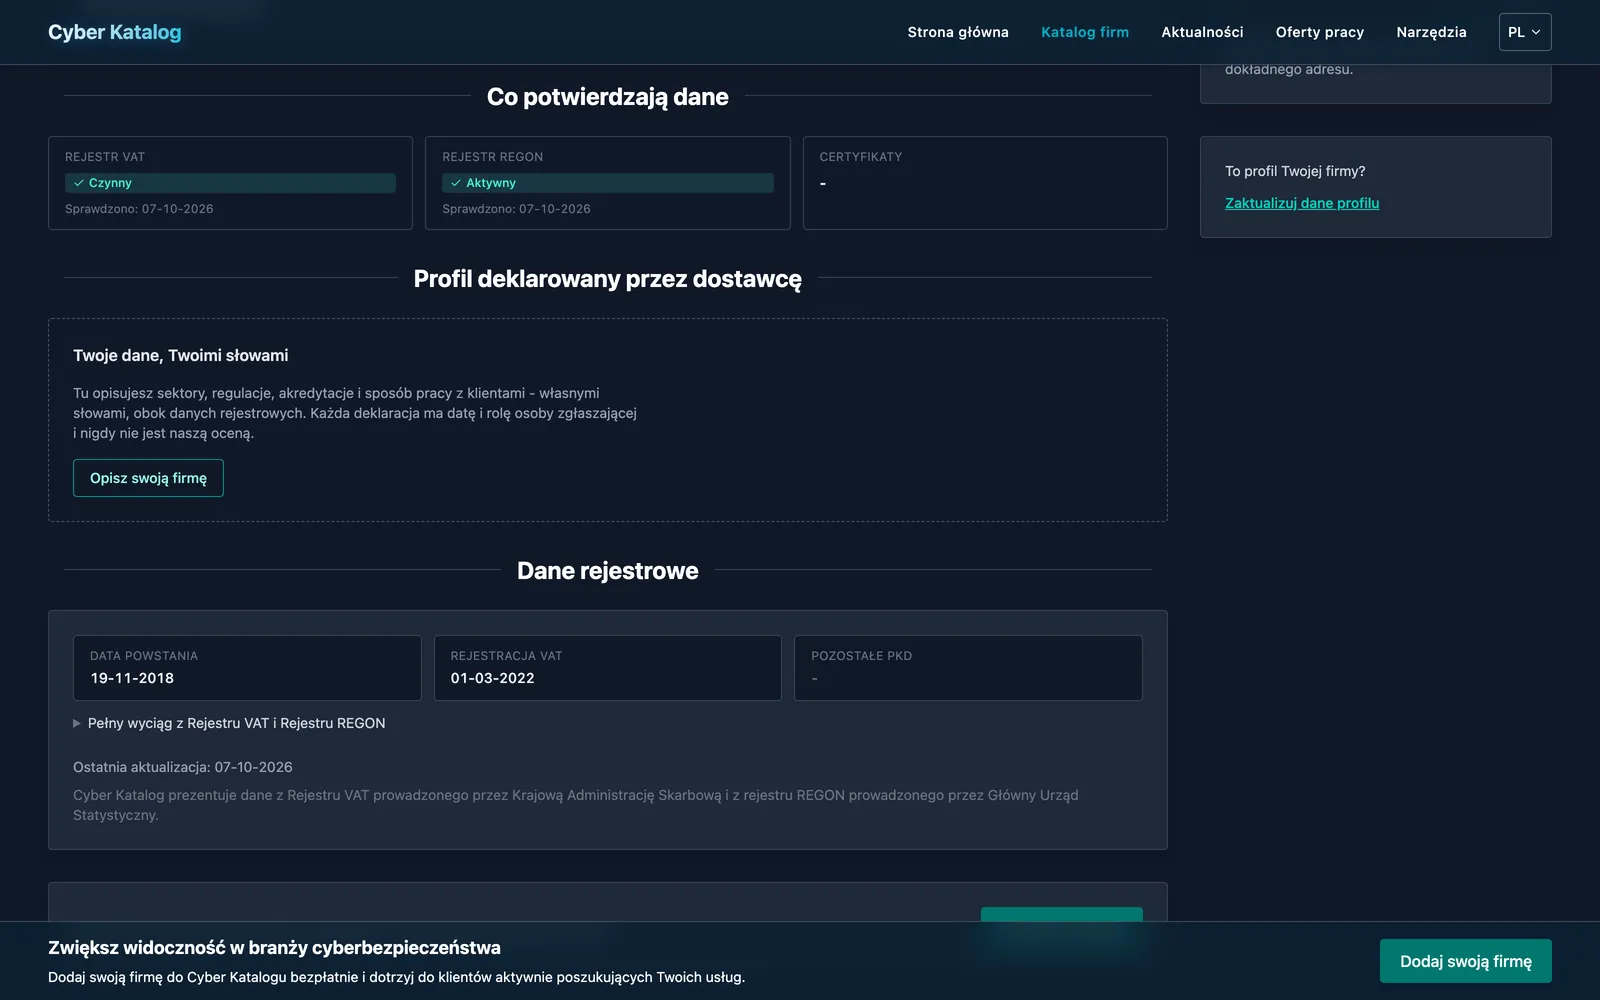
Każdy profil niesie dane rejestrowe z GUS/REGON oraz z białej listy podatników VAT Ministerstwa Finansów, dociągane po numerze NIP. Osobne, cykliczne zadanie sprawdza, czy firma nadal istnieje w rejestrze, więc katalog nie zbiera martwych wpisów.
Oferty pracy zbierane są automatycznie. Każda zmiana treści oferty zapisuje nową wersję rekordu z odsyłaczem do poprzedniej, po skrócie treści, więc historia oferty nie znika przy edycji.
Do kogo należy firma
Katalog odpowiada na pytanie, kto w Polsce robi daną rzecz. Kupujący z sektora publicznego albo podmiot objęty NIS2 bywa, że pyta o coś jeszcze: do kogo ta firma należy. Spółka zarejestrowana w Polsce może mieć kapitał w przewadze zagraniczny, a przy wyborze dostawcy bezpieczeństwa to bywa kryterium. Odpowiedź na to pytanie to warstwa market intelligence, którą katalog dobudował nad danymi rejestrowymi.
Tam, gdzie rejestry podają wspólników, profil firmy pokazuje strukturę właścicielską jako graf, do trzech poziomów w górę. Wspólników i akcjonariuszy podaje Krajowy Rejestr Sądowy. KRS nie mówi jednak, w jakim kraju zarejestrowany jest wspólnik zagraniczny, więc kraj pochodzi z globalnego indeksu LEI, który prowadzi GLEIF. Forma własności z rejestru REGON stoi przy firmie jako etykieta ze wskazanym źródłem, bo GUS klasyfikuje własność, ale nie podaje, kto jest właścicielem.
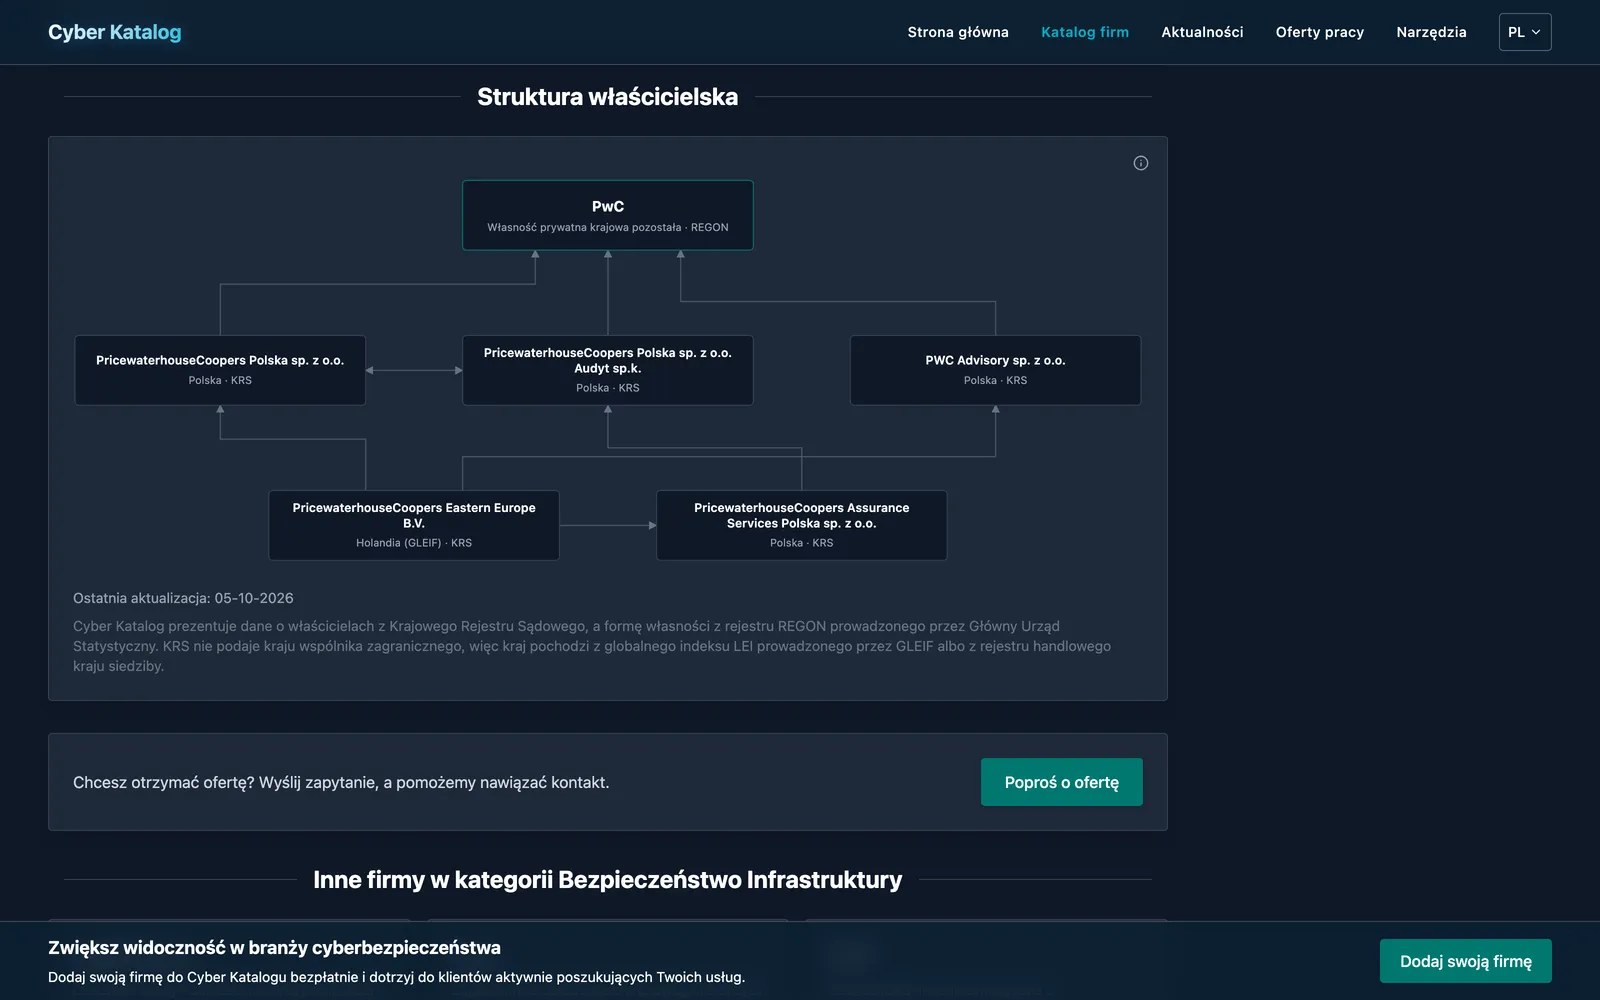
Węzeł niesie nazwę, kraj rejestracji i źródło, a graf datę odczytu. Pojęcie "pochodzenia kapitału" nie ma definicji ustawowej, a łańcuch właścicielski urywa się na granicy, więc graf podaje same fakty rejestrowe: wyliczona etykieta przy konkretnej firmie byłaby zarzutem wobec niej. Rejestry bywają też ze sobą niezgodne, a wtedy wygrywa wpis z późniejszą datą aktualizacji w samym rejestrze.
Rejestry pokazują stan bieżący i nadpisują go przy zmianie, więc zaplanowany przebieg zapisuje migawki struktury właścicielskiej. Do serwisu trafia z nich zestawienie, pull requestem, który sprawdza walidator schematu i te same bramki jakości co kod. Obok grafu profil wskazuje inne firmy z katalogu zarejestrowane pod tym samym adresem rejestrowym.
Frontend, mapa i telefon
Frontend napisany jest w SvelteKit z adapter-static (Svelte 5, Tailwind CSS 4, TypeScript, Vite) i renderuje się w całości statycznie na etapie builda. Cloudflare Workers serwuje gotowe pliki przez Static Assets, a build działa na Node 24.
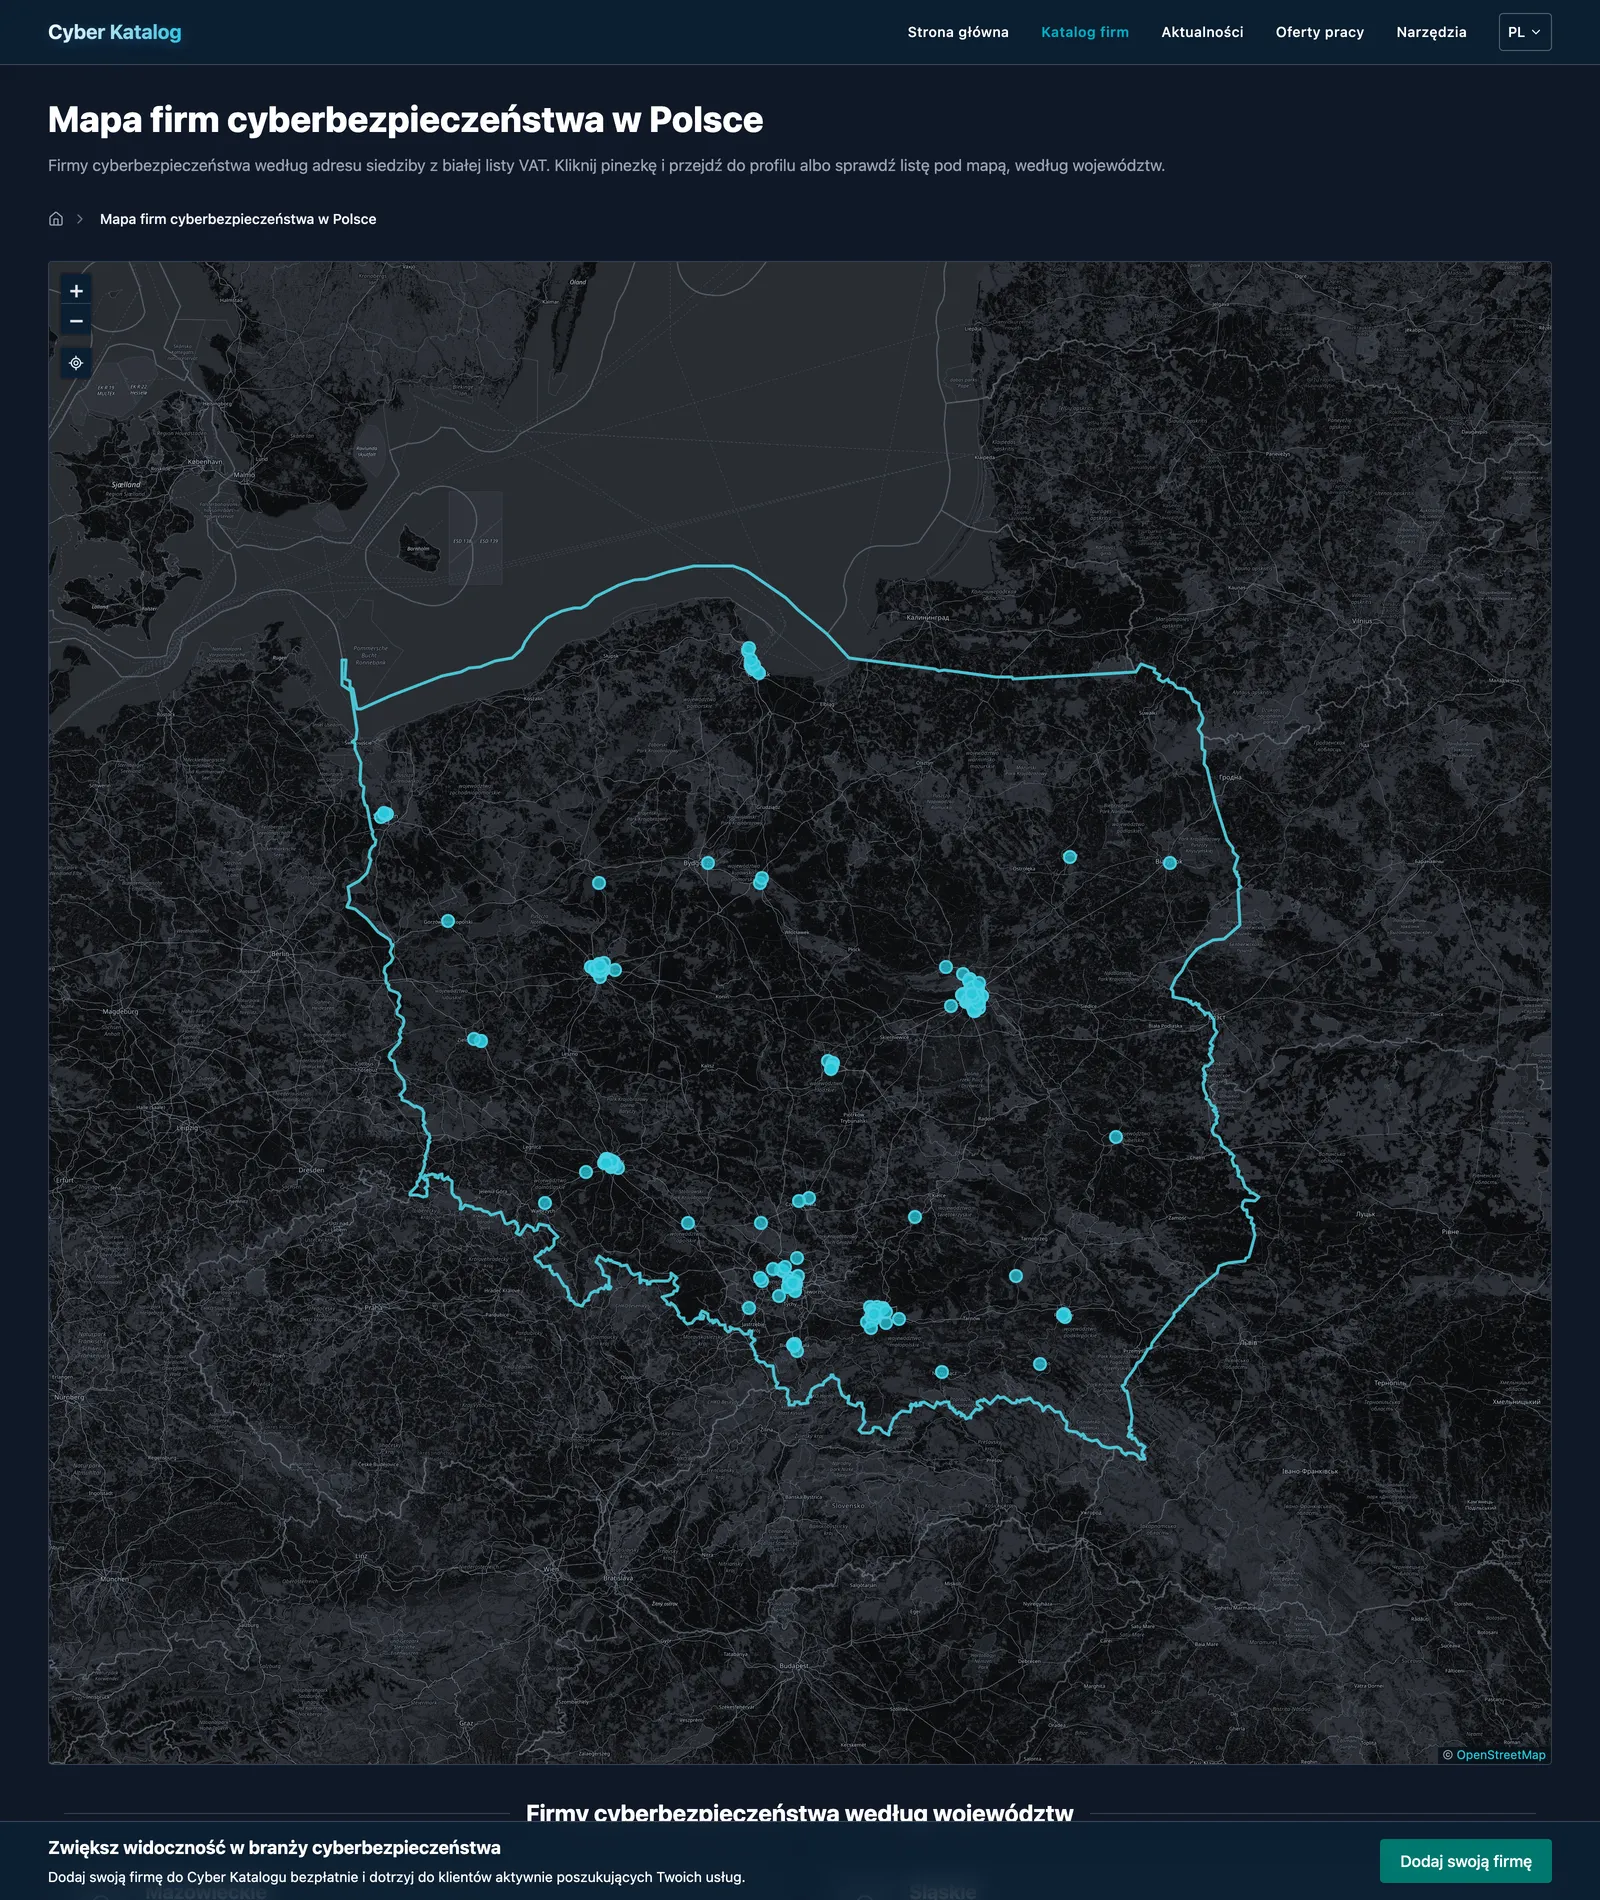
Rozmieszczenie firm na mapie obsługuje Leaflet, a mapa to jedyne miejsce w interfejsie, gdzie cały katalog widać naraz w układzie geograficznym.
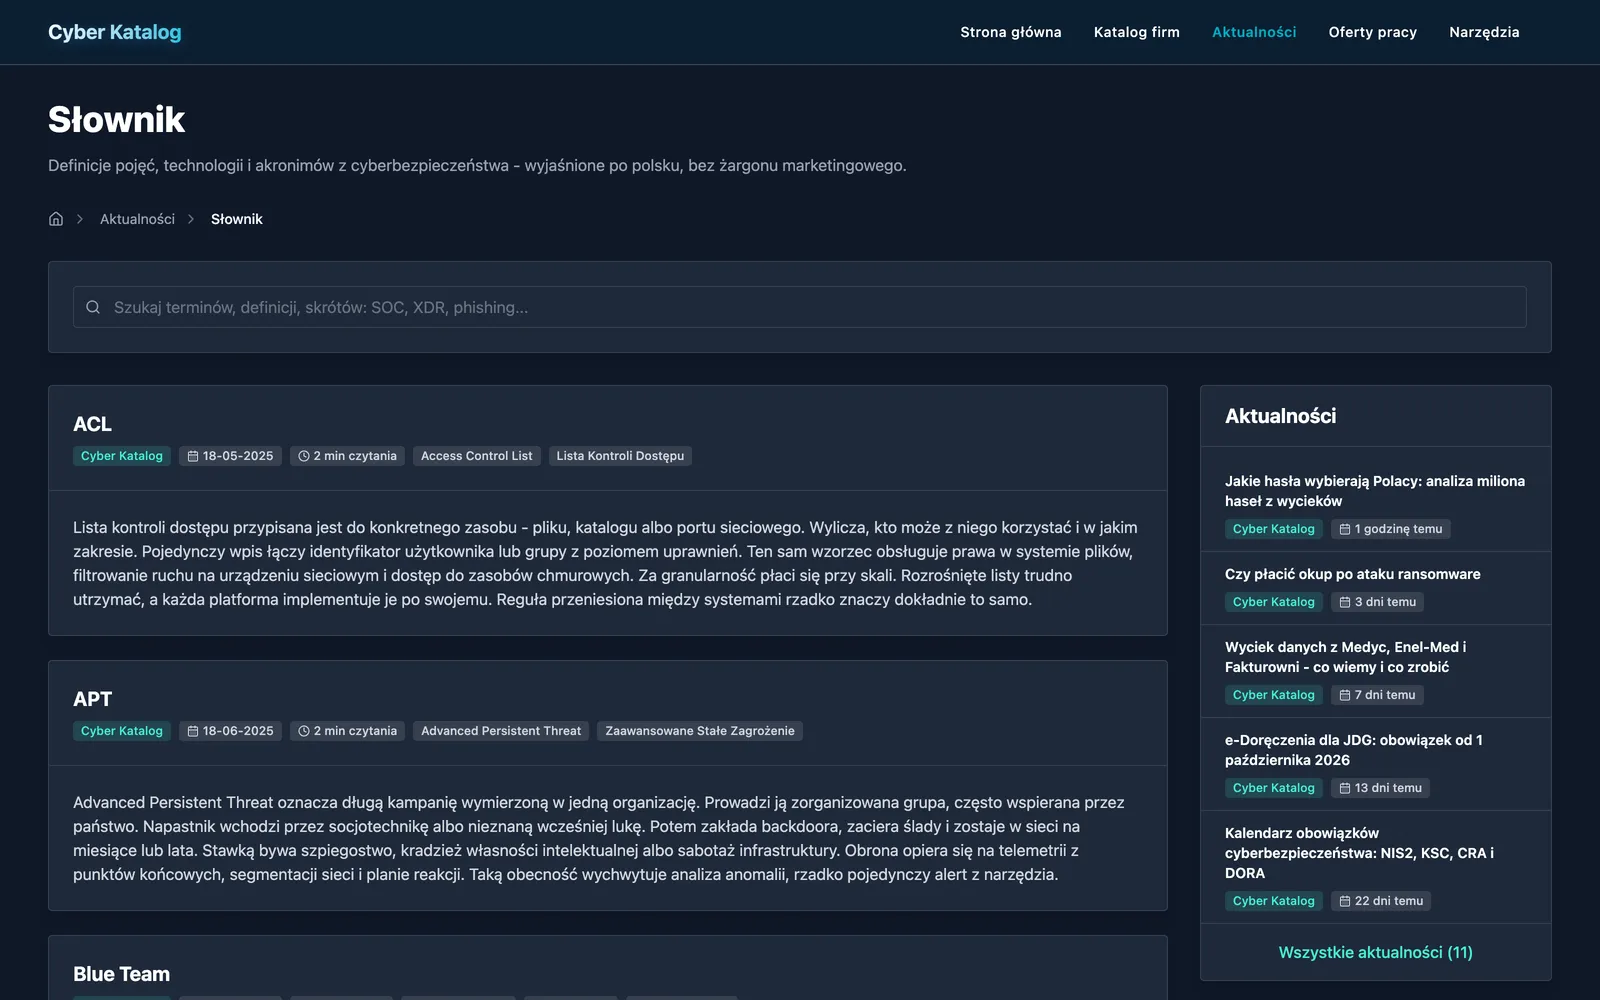
Zaplecze wiedzy domyka słownik, do którego haseł linkują artykuły i profile narzędzi, więc czytelnik nie musi wychodzić z serwisu, żeby sprawdzić skrót.
Architektura na Cloudflare
Na Cloudflare działają trzy usługi. Serwis pod cyberkatalog.pl jest w całości prerenderowany i serwowany przez Workers Static Assets, a API pod api.cyberkatalog.pl czyta z trzech baz D1, rozdzielonych według rodzaju danych: aktualności, oferty pracy i firmy. Trzecia usługa, proxy Listy Ostrzeżeń CSIRT NASK pod cert.cyberkatalog.pl, działa osobno, bo ma inne źródło danych i inny cykl życia niż API firm.
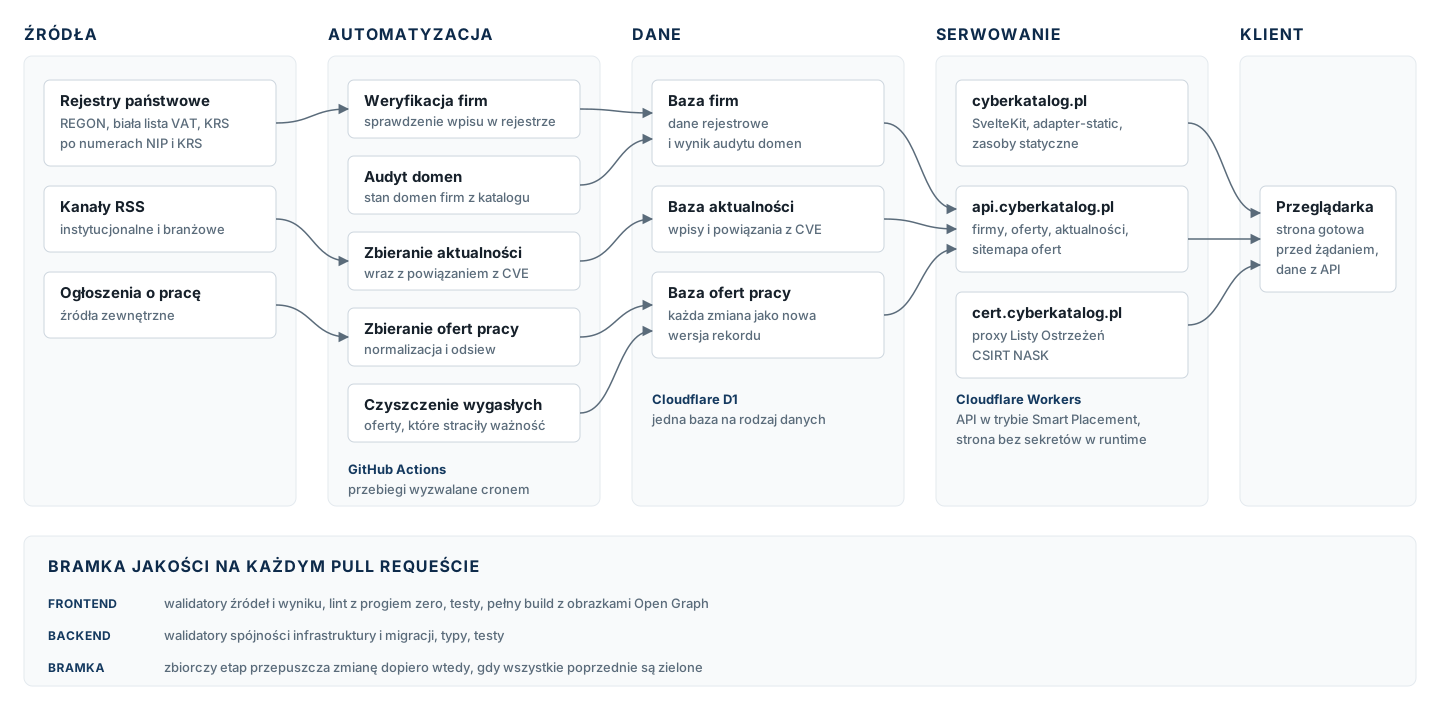
API działa w trybie Smart Placement, z włączoną obserwowalnością. Worker strony nie trzyma żadnych sekretów: build jest statyczny, Worker serwuje pliki, a dane idą z API. Sekrety ma tylko API. Przyjmuje ono zgłoszenia firm, wydarzeń i źródeł, chronione przez Turnstile, i wysyła o nich maile. Sekrety zgłoszeń czyta jeden moduł, a walidator w CI pilnuje, żeby żaden inny plik po nie nie sięgał. Im mniej miejsc potrafi coś ujawnić, tym mniej trzeba pilnować, i od takiego podziału odpowiedzialności zaczynamy przegląd architektury u klienta.
Harmonogram i pipeline
Cała warstwa danych opiera się na zaplanowanych przebiegach GitHub Actions, wyzwalanych cronem. Każde źródło ma własny przebieg i własny harmonogram, rozsunięty względem pozostałych, żeby zadania nie konkurowały o te same zasoby, a awaria jednego źródła nie zatrzymywała reszty. Osobne przebiegi zajmują się utrzymaniem: weryfikacją wpisów w rejestrach, audytem domen i czyszczeniem tego, co wygasło. Ten sam wzorzec zaplanowanych zadań wchodzi u nas w automatyzację procesów.
Przebiegi, które dotykają katalogu firm, czyli weryfikacja wpisów w rejestrach i audyt domen, zgłaszają awarię na Slacku, więc nie czeka ona, aż ktoś zajrzy do logów.
Bramki jakości
CI uruchamia się na każdym pull requeście, osobno dla backendu i frontendu. W backendzie walidatory pilnują rzeczy, które łatwo przeoczyć przy ręcznym review: przypięcia akcji GitHuba do konkretnej wersji, pokrycia ponawianiem zapytań do D1, podpięcia migracji D1, tras sitemapy i tego, który moduł czyta sekrety zgłoszeń. Do tego dochodzą kontrola typów i testy.
Frontend ma osobne etapy: walidatory źródeł i wyniku, lint z progiem zero, testy oraz pełny build z generowaniem obrazków Open Graph. Bramka zbiorcza na końcu przepuszcza tylko komplet zielonych etapów.
Co z tego wynika
Każda z tych decyzji ma swoją cenę. Harmonogram bez ręcznych kroków wymaga alarmu, który ktoś odbierze, a bramka, która nie przepuszcza kompromisów, czasem zatrzyma pilną zmianę. Ten sam rachunek robimy przy cyberbezpieczeństwie i zgodności.
Wykorzystane technologie
- SvelteKit
- Cloudflare Workers
- Cloudflare D1
- TypeScript
- Svelte
- Node.js
- Tailwind CSS
- GitHub Actions